
Tipos de datos en una pyme
En las pequeñas y medianas empresas se generan y manejan diversos tipos de datos en el día a día.
Algunos de los datos típicos en una pyme incluyen:

Datos del cliente

Datos de venta y facturación

Datos de inventario y operaciones

Datos de recursos humanos

Datos de marketing y atención al cliente

Datos financieros

Datos de proveedores y socios
Estos datos pueden almacenarse en diferentes formatos y lugares: desde archivos de Excel o Google Sheets, hasta bases de datos en sistemas de gestión empresarial (ERP/CRM). Lo importante es reconocer las fuentes de datos relevantes. Por ejemplo, una base de datos de la pyme puede incluir datos de clientes, inventarios y proveedores en un mismo repositorio, facilitando la consulta y análisis integrados. En general, entender qué datos manejamos es el primer paso para poder gestionarlos mejor y aprovecharlos con IA.
¿Por qué son tan importantes los datos en IA?
Los algoritmos de inteligencia artificial aprenden a partir de datos. Eso significa que su rendimiento depende por completo de la calidad, cantidad y relevancia de la información que reciben. Si los datos están desordenados, incompletos o son incorrectos, los resultados de la IA también lo serán.
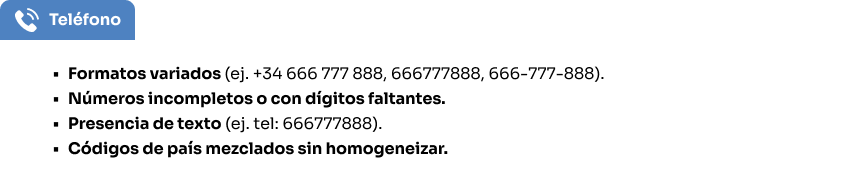
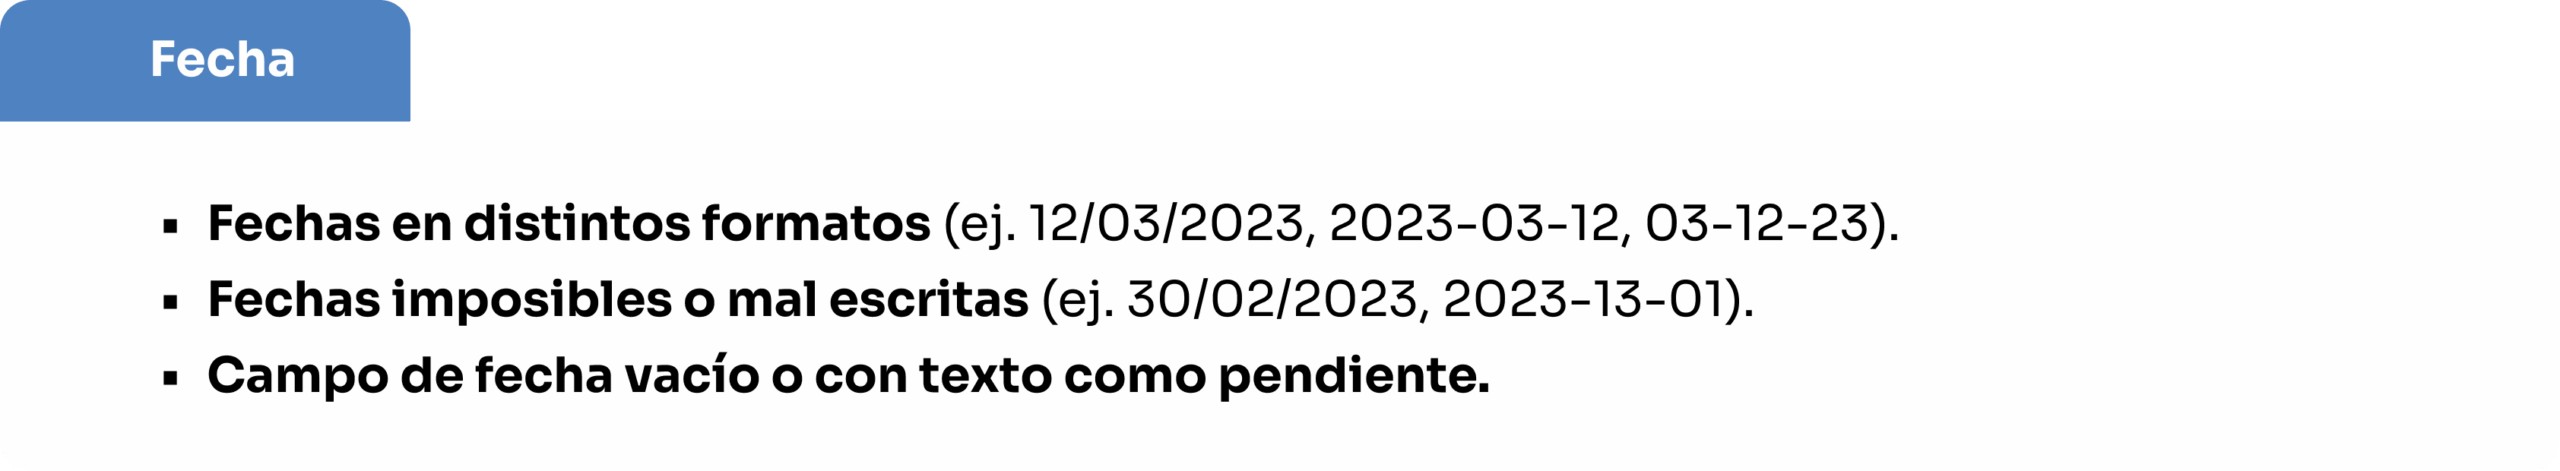
Veamos la siguiente tabla:
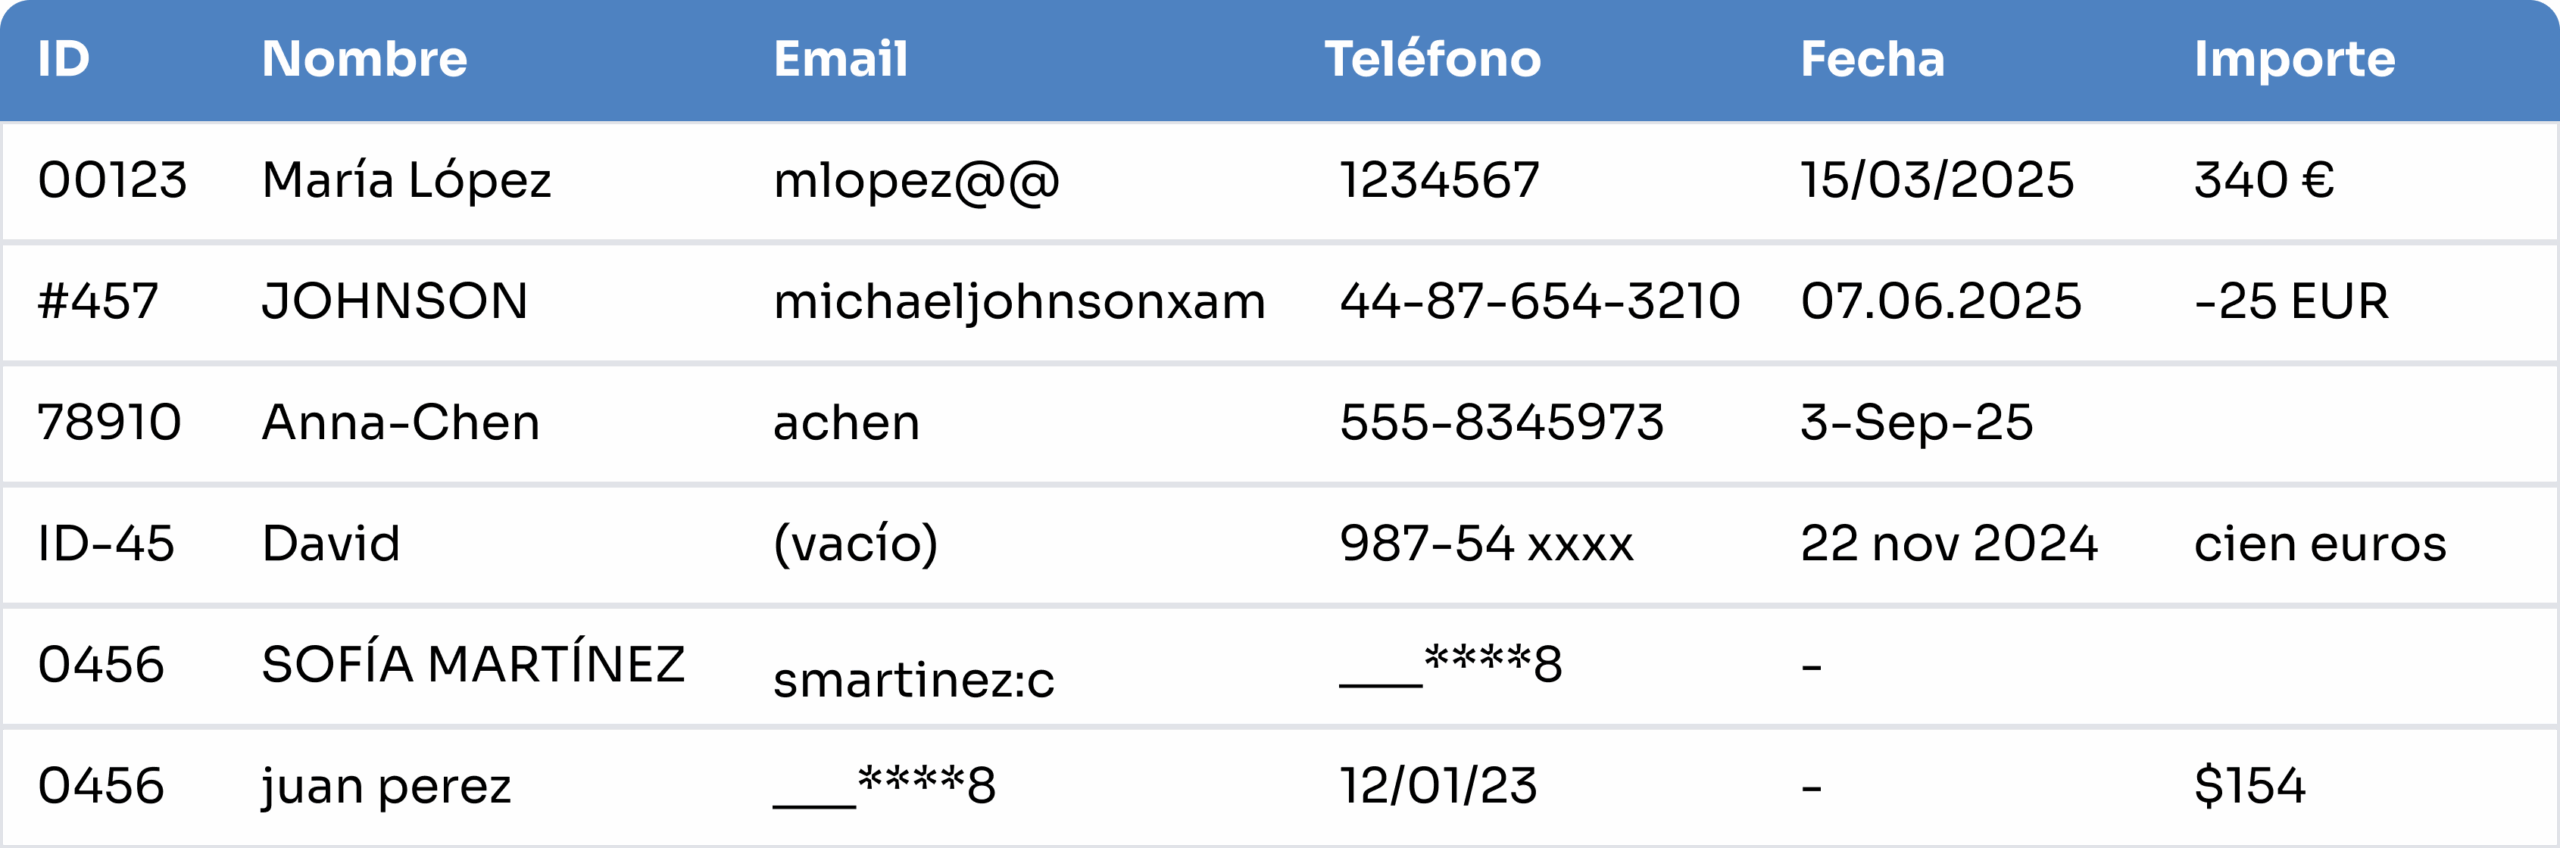
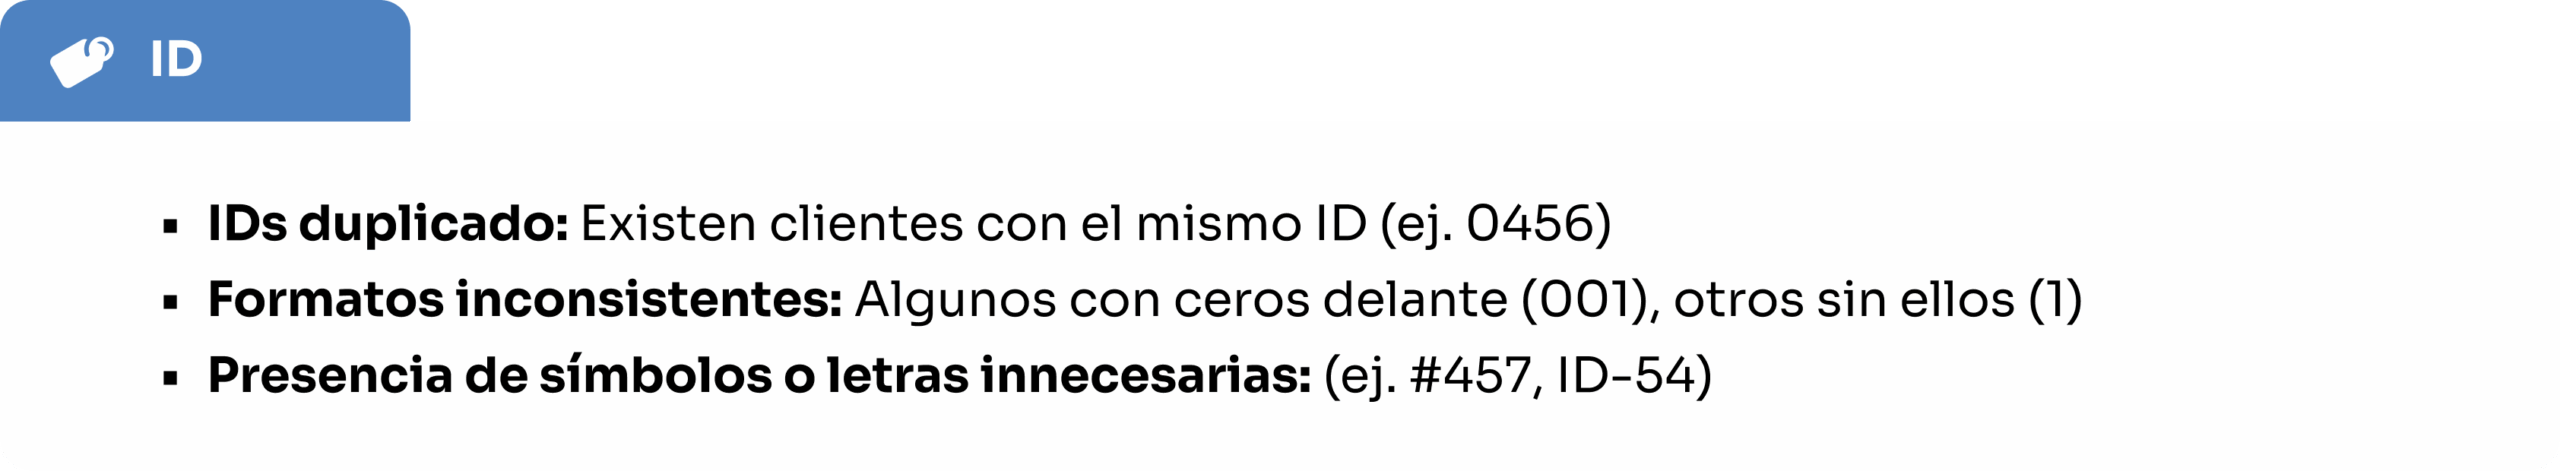
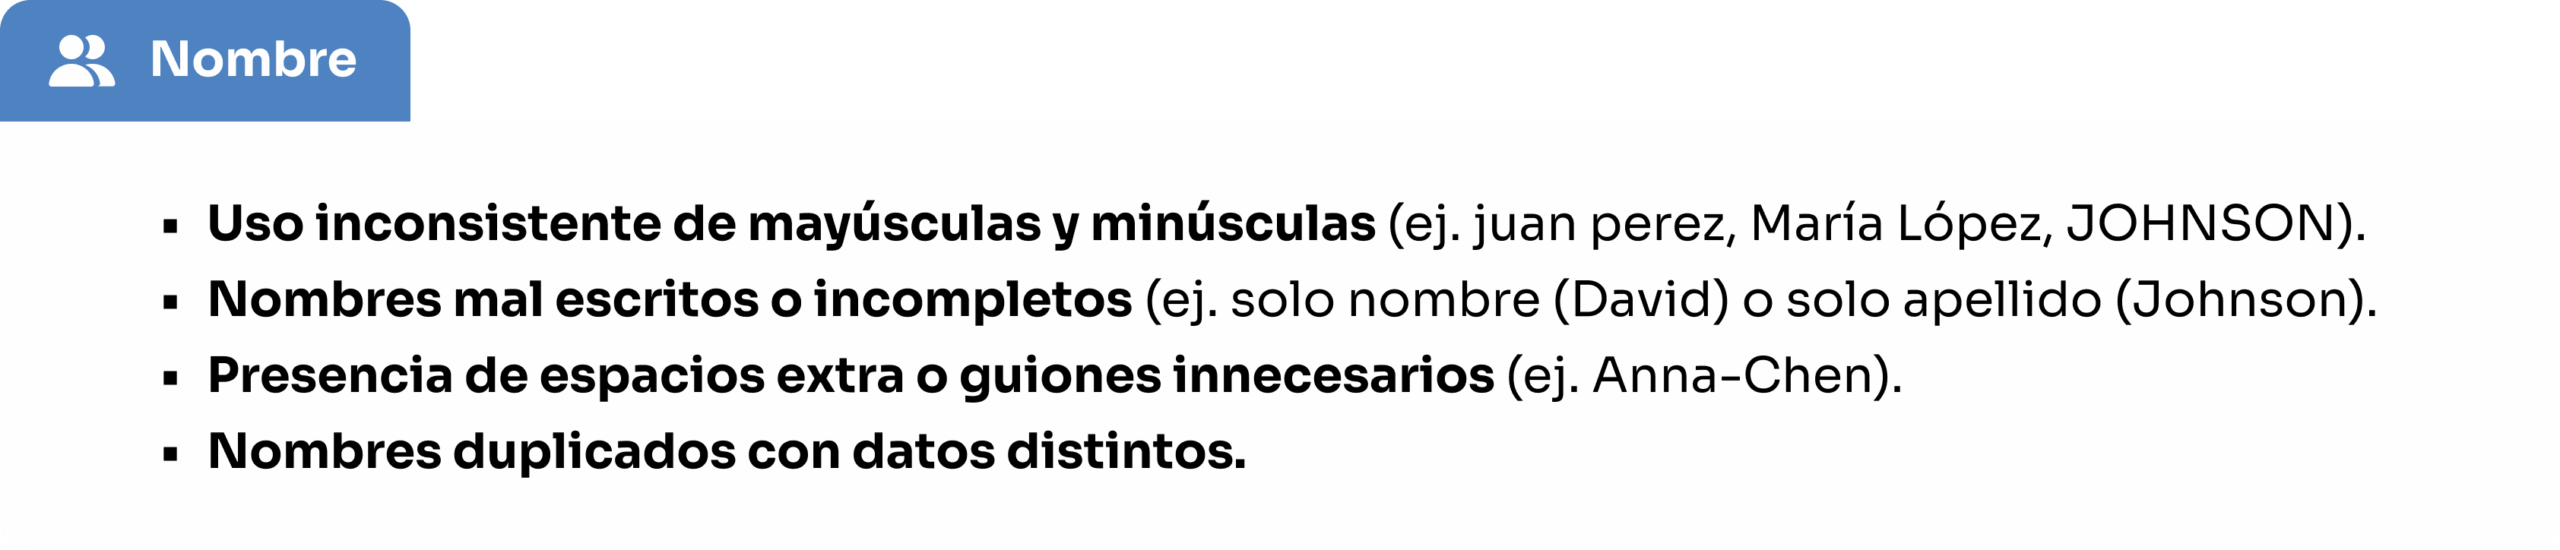
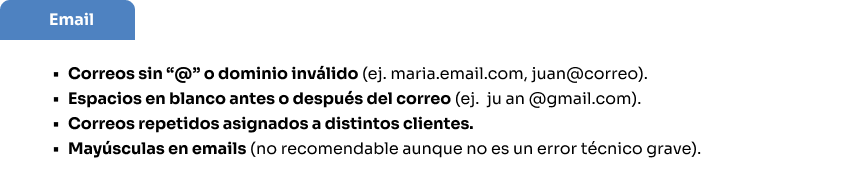
¿Detectas qué errores se suelen cometer?

Buenas Prácticas de Gestión de Datos
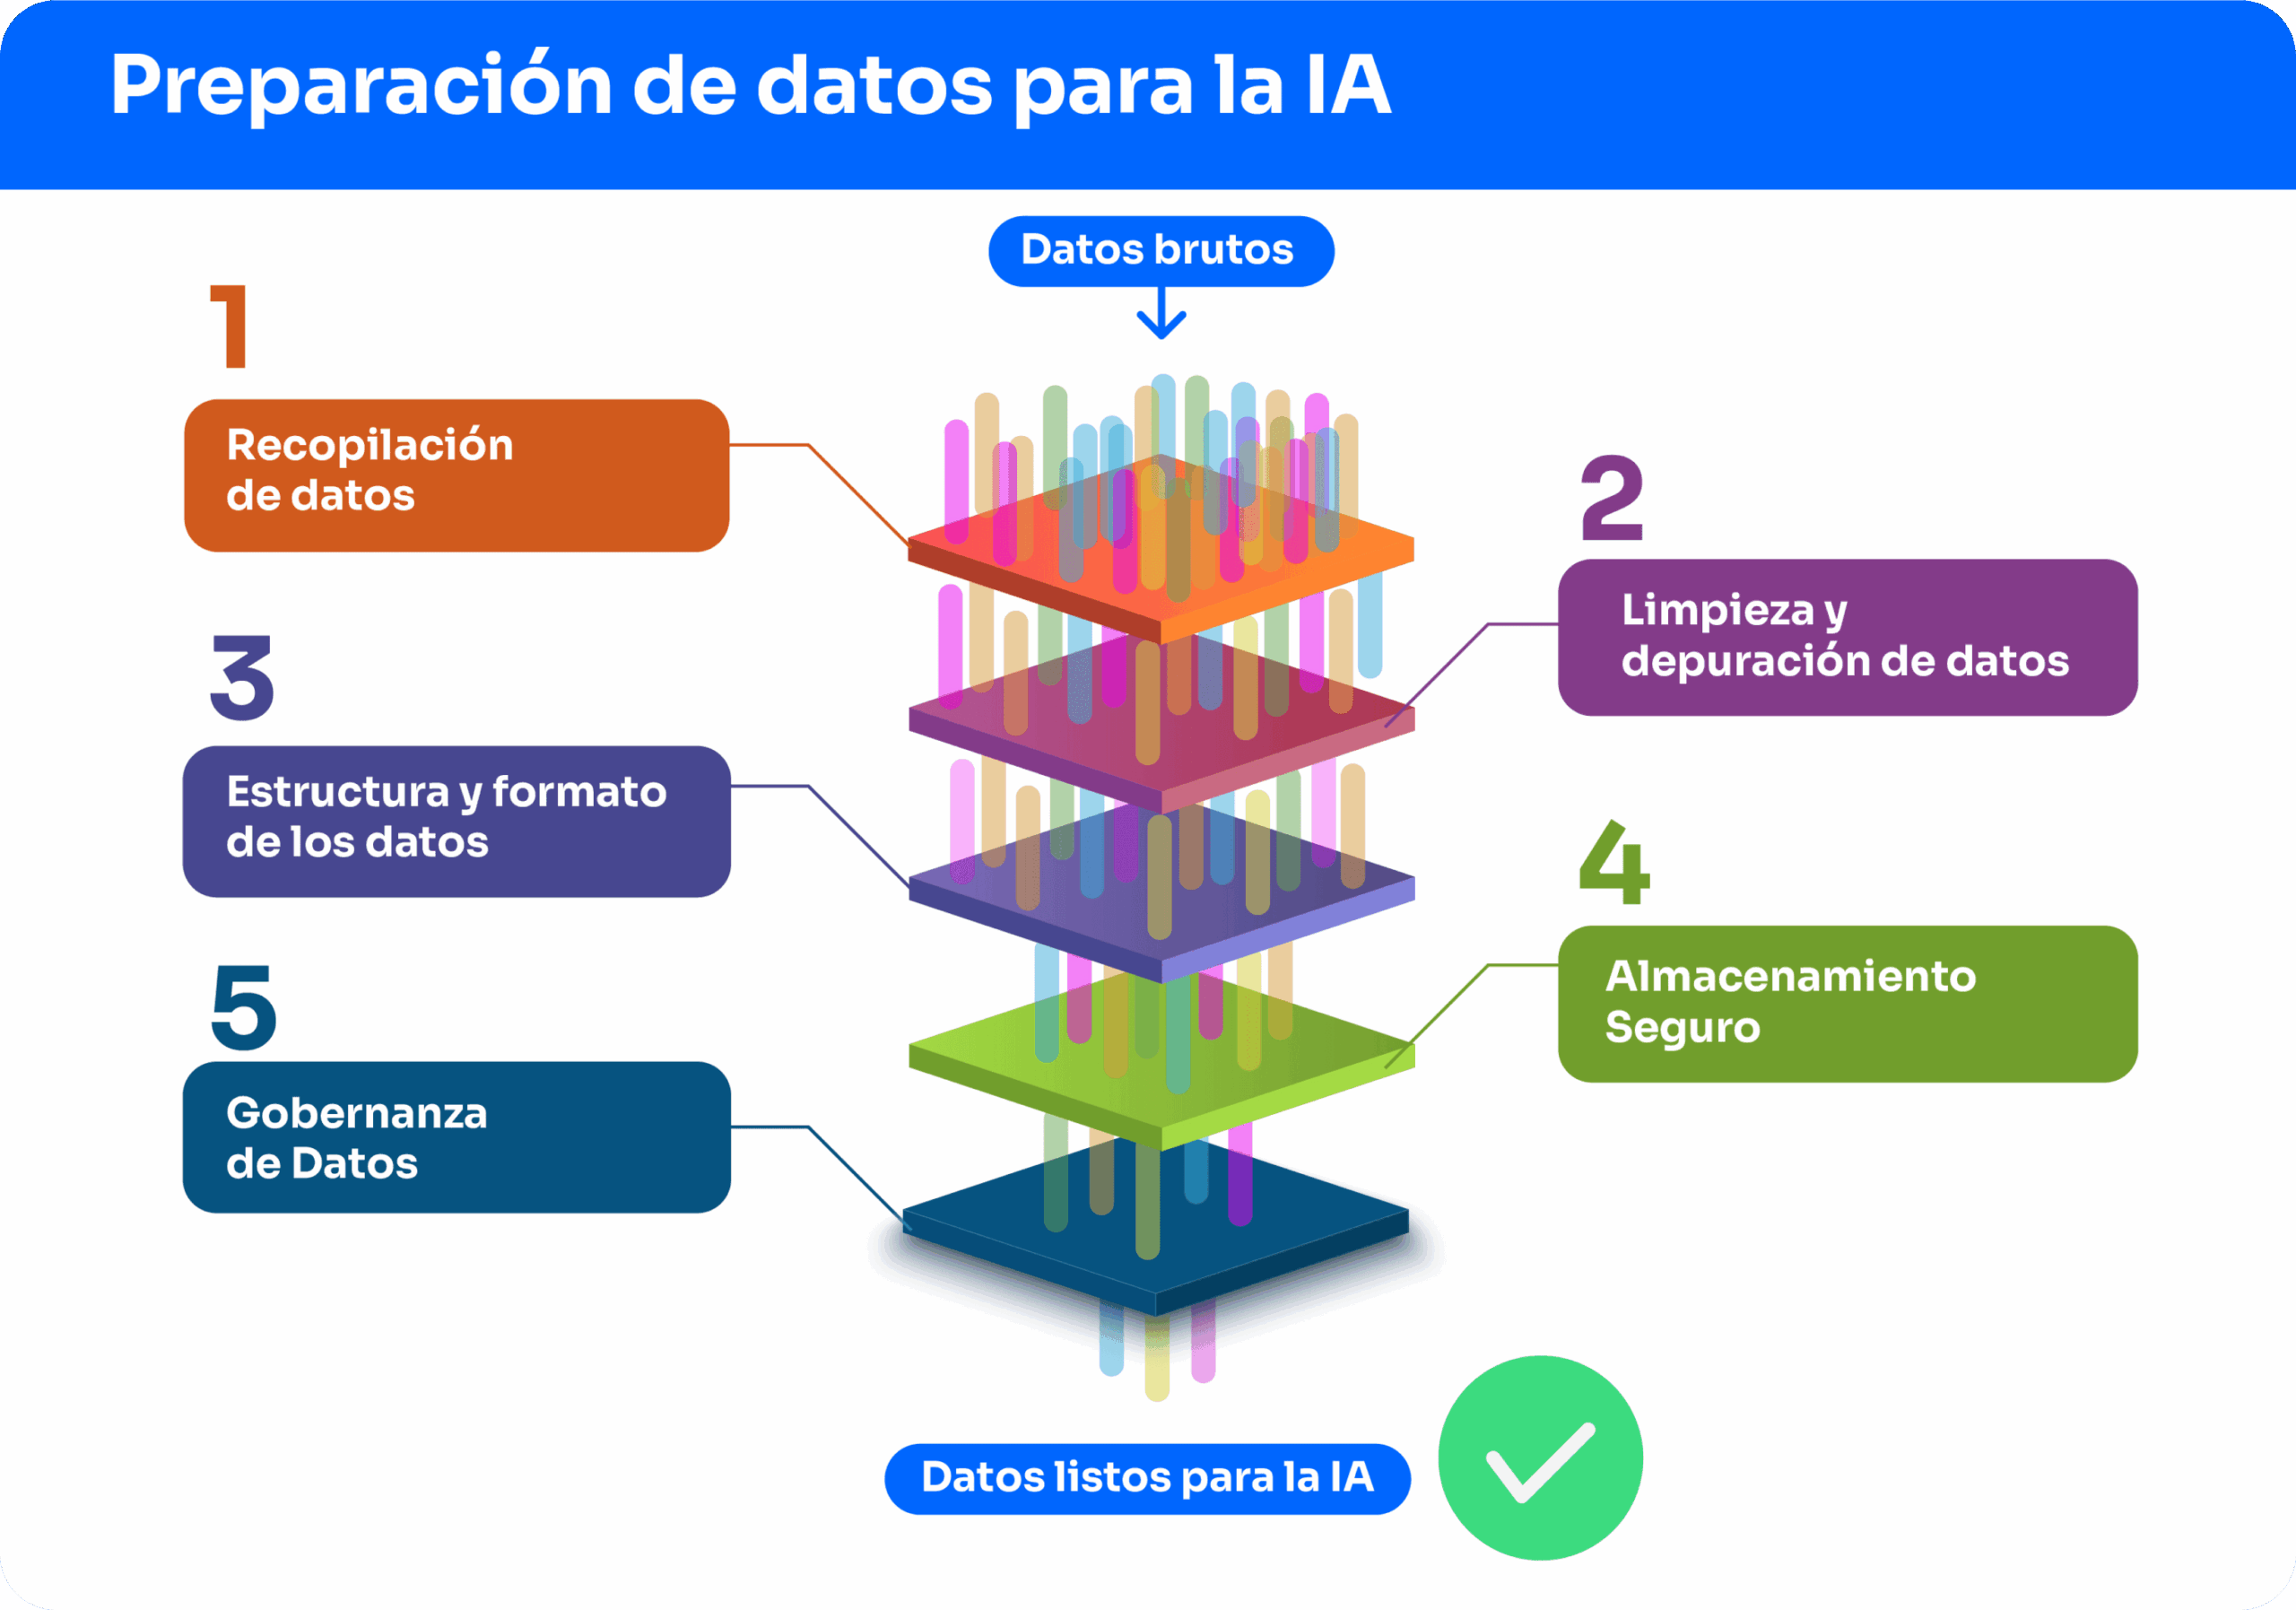
Para preparar el camino hacia la IA, una pyme debe adoptar buenas prácticas en la gestión de sus datos. Esto abarca desde cómo se recopilan hasta cómo se almacenan y mantienen en el tiempo. A continuación, se presentan las principales prácticas recomendadas:
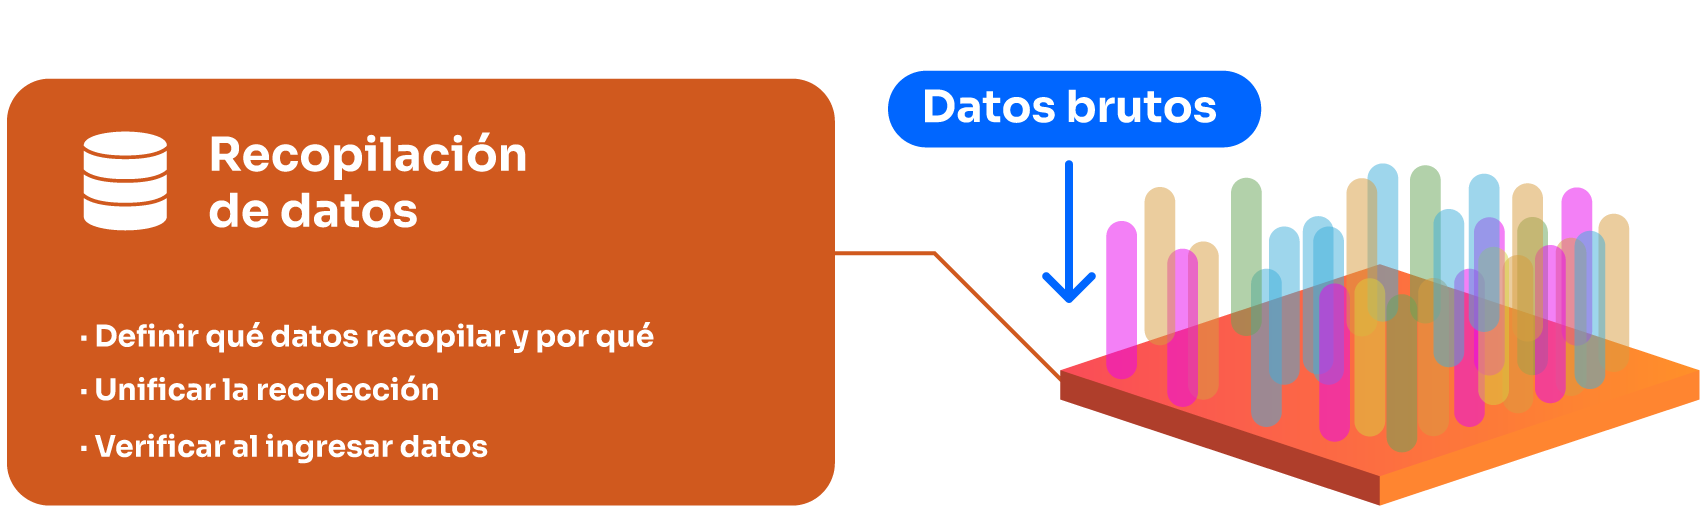
No se trata de acumular datos porque sí, sino de capturar la información que aporte valor al negocio. Identifica qué datos son realmente útiles para tus objetivos (ventas, clientes, operaciones, etc.) y evita recolectar datos irrelevantes que solo ocupan espacio. Por ejemplo, casi todas las pymes registran datos básicos de contacto de clientes, pero podrían omitir campos innecesarios.
Establece procesos claros para cómo y dónde se recogen los datos en cada área. Formularios estandarizados, sistemas unificados (un solo CRM para todos los clientes, un solo sistema de inventario) ayudan a que la información no quede dispersa. Siempre que sea posible, automatiza la captura de datos para reducir errores manuales (por ejemplo, integrando la tienda en línea con la base de datos de inventario).
Implementa controles de calidad en el momento de introducir los datos. Por ejemplo, revisar que un nuevo registro de cliente tenga el formato correcto (correo válido, campos completos) antes de guardarlo. Esto evita errores al sistema desde el inicio.
Periódicamente revisa la base de datos para detectar clientes duplicados, registros repetidos o inconsistencias (por ejemplo, el mismo cliente ingresado dos veces con nombres ligeramente distintos). Los duplicados pueden causar confusión y análisis erróneos; es fundamental identificarlos y consolidarlos . Del mismo modo, corrige datos obviamente incorrectos (fechas imposibles, campos mal colocados) y elimina registros obsoletos.
Si faltan datos importantes en algunos registros (por ejemplo, clientes sin teléfono o ventas sin dato de fecha), define una política para completarlos. Puede ser contactando al cliente para actualizar la información, o al menos marcar esos casos para excluirlos de ciertos análisis. Datos incompletos pueden sesgar los resultados si no se manejan adecuadamente.
La limpieza de datos no es tarea de una sola vez. Conviene programar limpiezas periódicas (mensuales, trimestrales, según el volumen de cambios) para mantener la base al día . Esto incluye eliminar datos desactualizados (p. ej., contactos que ya no responden) y verificar que la información siga siendo correcta. Un dato preciso y vigente evitará decisiones basadas en información caduca.
Mantén un formato consistente para cada tipo de dato . Por ejemplo, decidir un formato único para fechas (p. ej. AAAA-MM-DD), para nombres (separar nombre y apellidos en campos distintos) o para direcciones (todos los campos en mayúsculas, etc.). La estandarización facilita combinar datos de fuentes diferentes sin conflictos y mejora la claridad.
Siempre que sea posible, organiza la información en estructuras tabulares (filas y columnas) o bases de datos relacionales. Los datos estructurados (como tablas de clientes o ventas) son más fáciles de filtrar y analizar. En cambio, los datos no estructurados (como correos electrónicos, textos libres o imágenes) requieren pasos extra para aprovecharse en IA. Si manejas datos no estructurados, considera clasificarlos o extraer información relevante para darles cierta estructura (por ejemplo, etiquetar tickets de soporte por tema).
Los algoritmos de IA generalmente trabajan mejor con datos numéricos. Muchas veces habrá que convertir información en números o categorías codificadas para poder usarlas en modelos . Por ejemplo, si tienes “satisfacción del cliente” registrada como “Alta/Media/Baja”, podrías convertirlo a valores 3/2/1. Asegúrate de documentar estos cambios de formato para no perder el significado original de los datos.
Evita tener “silos” de datos aislados en diferentes computadoras o departamentos. Es preferible consolidar los datos clave en un repositorio central (por ejemplo, una base de datos en servidor local o en la nube, o al menos una carpeta compartida segura). Esto garantiza que todos trabajen con la misma información actualizada y facilita hacer copias de seguridad.
Implementa medidas de seguridad apropiadas: control de accesos (solo personal autorizado debe ver datos sensibles como nóminas o clientes VIP), contraseñas robustas, y cifrado si es pertinente. Realiza backups (copias de seguridad) periódicas de la información para prevenir pérdidas por fallos técnicos. El almacenamiento debe cumplir con normativas de protección de datos – por ejemplo, si usas servicios en la nube, verifica que cumplan estándares de seguridad y privacidad.
A medida que la empresa crece, crecerán sus datos. Escoge soluciones de almacenamiento que puedan ampliarse (más capacidad, más usuarios) sin perder rendimiento. Pasar de Excel a una base de datos, o de un servidor local a un servicio en la nube, puede ser necesario si el volumen de datos aumenta significativamente.
La gestión de los datos debe tener responsables claros. Hay que definir quién puede introducir información, quién la revisa y cada cuánto se actualiza. También es importante formar al personal para que entienda la importancia de mantener los datos en buen estado, creando así una cultura empresarial orientada a la calidad del dato. Por tanto debemos:
La gobernanza de datos implica establecer reglas claras sobre cómo se manejan los datos y quién se encarga de ello . Por ejemplo, definir quién puede crear o modificar registros, cada cuánto se revisa la calidad de los datos y cómo se reportan errores. Asigna responsables (individuales o por departamento) para velar por la calidad del dato. En algunas empresas se nombra un “Chief Data Officer” o similar, pero en una pyme puede ser simplemente un rol adicional del gerente de TI o de procesos
Asegúrate de que la gestión de datos apoye los objetivos del negocio. La gobernanza debe alinear los datos con la estrategia y visión de la empresa. Por ejemplo, si la meta es mejorar la atención al cliente, las políticas de datos deben priorizar la obtención de feedback de clientes y su correcta integración en las decisiones.
Fomenta en el equipo la importancia de “cuidar” los datos. Todos los empleados que recolectan o usan datos deben comprender por qué mantenerlos limpios y organizados beneficia a su propio trabajo. Una cultura donde cada uno siente responsabilidad por la calidad de los datos reduce mucho el riesgo de descuidos. Capacita al personal en buenas prácticas (por ejemplo, talleres breves sobre cómo introducir datos correctamente en el sistema) . Cuando la empresa valora los datos como activo, es más probable que la IA futura sea exitosa, pues se apoyará en cimientos de información sólidos.
1. Recopilación de datos
No se trata de acumular datos porque sí, sino de capturar la información que aporte valor al negocio. Identifica qué datos son realmente útiles para tus objetivos (ventas, clientes, operaciones, etc.) y evita recolectar datos irrelevantes que solo ocupan espacio. Por ejemplo, casi todas las pymes registran datos básicos de contacto de clientes, pero podrían omitir campos innecesarios.
Establece procesos claros para cómo y dónde se recogen los datos en cada área. Formularios estandarizados, sistemas unificados (un solo CRM para todos los clientes, un solo sistema de inventario) ayudan a que la información no quede dispersa. Siempre que sea posible, automatiza la captura de datos para reducir errores manuales (por ejemplo, integrando la tienda en línea con la base de datos de inventario).
Implementa controles de calidad en el momento de introducir los datos. Por ejemplo, revisar que un nuevo registro de cliente tenga el formato correcto (correo válido, campos completos) antes de guardarlo. Esto evita errores al sistema desde el inicio.
2. Limpieza y depuración de datos
Periódicamente revisa la base de datos para detectar clientes duplicados, registros repetidos o inconsistencias (por ejemplo, el mismo cliente ingresado dos veces con nombres ligeramente distintos). Los duplicados pueden causar confusión y análisis erróneos; es fundamental identificarlos y consolidarlos . Del mismo modo, corrige datos obviamente incorrectos (fechas imposibles, campos mal colocados) y elimina registros obsoletos.
Si faltan datos importantes en algunos registros (por ejemplo, clientes sin teléfono o ventas sin dato de fecha), define una política para completarlos. Puede ser contactando al cliente para actualizar la información, o al menos marcar esos casos para excluirlos de ciertos análisis. Datos incompletos pueden sesgar los resultados si no se manejan adecuadamente.
La limpieza de datos no es tarea de una sola vez. Conviene programar limpiezas periódicas (mensuales, trimestrales, según el volumen de cambios) para mantener la base al día . Esto incluye eliminar datos desactualizados (p. ej., contactos que ya no responden) y verificar que la información siga siendo correcta. Un dato preciso y vigente evitará decisiones basadas en información caduca.
3. Estructura y formato de los datos
Mantén un formato consistente para cada tipo de dato . Por ejemplo, decidir un formato único para fechas (p. ej. AAAA-MM-DD), para nombres (separar nombre y apellidos en campos distintos) o para direcciones (todos los campos en mayúsculas, etc.). La estandarización facilita combinar datos de fuentes diferentes sin conflictos y mejora la claridad.
Siempre que sea posible, organiza la información en estructuras tabulares (filas y columnas) o bases de datos relacionales. Los datos estructurados (como tablas de clientes o ventas) son más fáciles de filtrar y analizar. En cambio, los datos no estructurados (como correos electrónicos, textos libres o imágenes) requieren pasos extra para aprovecharse en IA. Si manejas datos no estructurados, considera clasificarlos o extraer información relevante para darles cierta estructura (por ejemplo, etiquetar tickets de soporte por tema).
Los algoritmos de IA generalmente trabajan mejor con datos numéricos. Muchas veces habrá que convertir información en números o categorías codificadas para poder usarlas en modelos . Por ejemplo, si tienes “satisfacción del cliente” registrada como “Alta/Media/Baja”, podrías convertirlo a valores 3/2/1. Asegúrate de documentar estos cambios de formato para no perder el significado original de los datos.
4. Almacenamiento seguro y accesible
Evita tener “silos” de datos aislados en diferentes computadoras o departamentos. Es preferible consolidar los datos clave en un repositorio central (por ejemplo, una base de datos en servidor local o en la nube, o al menos una carpeta compartida segura). Esto garantiza que todos trabajen con la misma información actualizada y facilita hacer copias de seguridad.
Implementa medidas de seguridad apropiadas: control de accesos (solo personal autorizado debe ver datos sensibles como nóminas o clientes VIP), contraseñas robustas, y cifrado si es pertinente. Realiza backups (copias de seguridad) periódicas de la información para prevenir pérdidas por fallos técnicos. El almacenamiento debe cumplir con normativas de protección de datos – por ejemplo, si usas servicios en la nube, verifica que cumplan estándares de seguridad y privacidad.
A medida que la empresa crece, crecerán sus datos. Escoge soluciones de almacenamiento que puedan ampliarse (más capacidad, más usuarios) sin perder rendimiento. Pasar de Excel a una base de datos, o de un servidor local a un servicio en la nube, puede ser necesario si el volumen de datos aumenta significativamente.
5. Gobernanza de Datos
La gestión de los datos debe tener responsables claros. Hay que definir quién puede introducir información, quién la revisa y cada cuánto se actualiza. También es importante formar al personal para que entienda la importancia de mantener los datos en buen estado, creando así una cultura empresarial orientada a la calidad del dato. Por tanto debemos:
La gobernanza de datos implica establecer reglas claras sobre cómo se manejan los datos y quién se encarga de ello . Por ejemplo, definir quién puede crear o modificar registros, cada cuánto se revisa la calidad de los datos y cómo se reportan errores. Asigna responsables (individuales o por departamento) para velar por la calidad del dato. En algunas empresas se nombra un “Chief Data Officer” o similar, pero en una pyme puede ser simplemente un rol adicional del gerente de TI o de procesos
Asegúrate de que la gestión de datos apoye los objetivos del negocio. La gobernanza debe alinear los datos con la estrategia y visión de la empresa. Por ejemplo, si la meta es mejorar la atención al cliente, las políticas de datos deben priorizar la obtención de feedback de clientes y su correcta integración en las decisiones.
Fomenta en el equipo la importancia de “cuidar” los datos. Todos los empleados que recolectan o usan datos deben comprender por qué mantenerlos limpios y organizados beneficia a su propio trabajo. Una cultura donde cada uno siente responsabilidad por la calidad de los datos reduce mucho el riesgo de descuidos. Capacita al personal en buenas prácticas (por ejemplo, talleres breves sobre cómo introducir datos correctamente en el sistema) . Cuando la empresa valora los datos como activo, es más probable que la IA futura sea exitosa, pues se apoyará en cimientos de información sólidos.
Requisitos básicos de los datos para que sean útiles en IA
No todos los datos son automáticamente aprovechables para proyectos de inteligencia artificial. Es necesario que cumplan con ciertos requisitos de calidad y pertinencia para que realmente aporten valor.
A continuación, los criterios básicos que debe reunir un conjunto de datos antes de usarse en herramientas de IA:
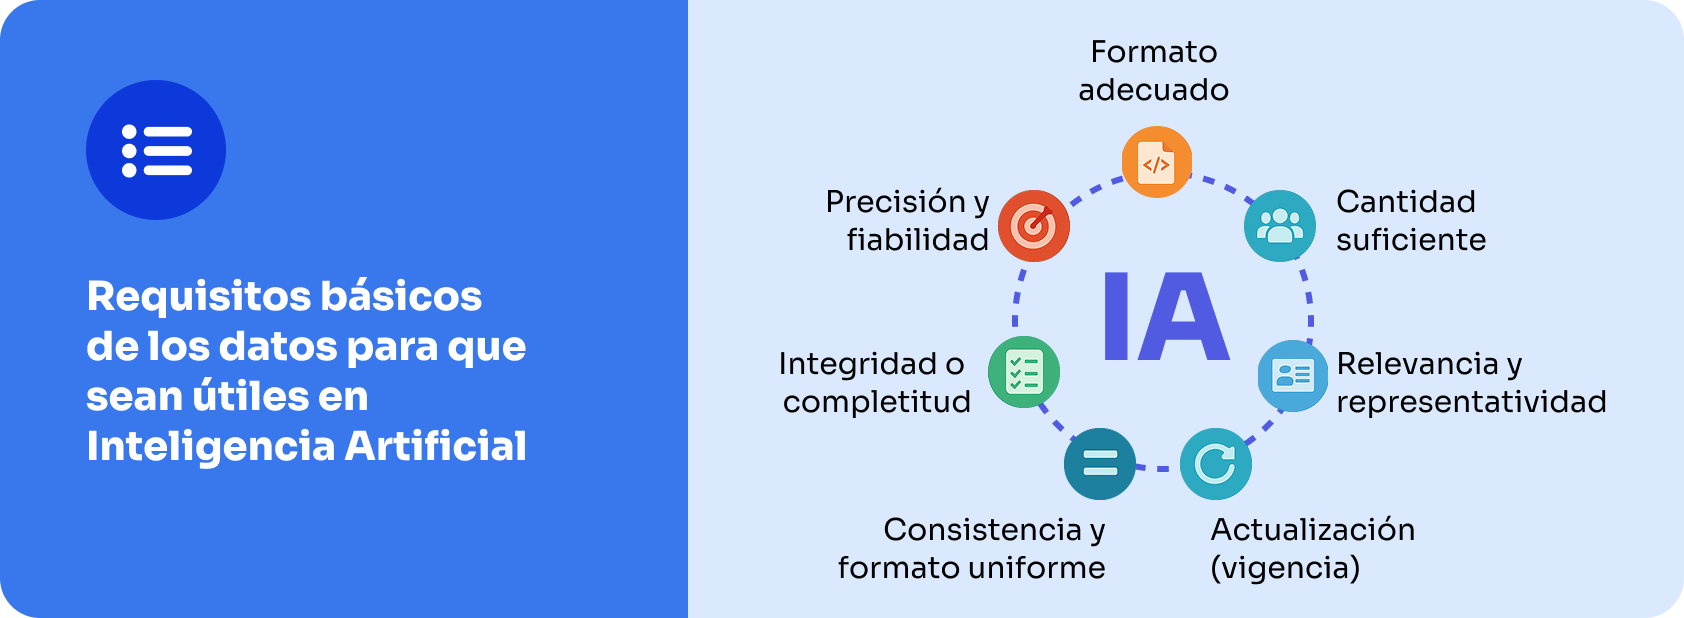
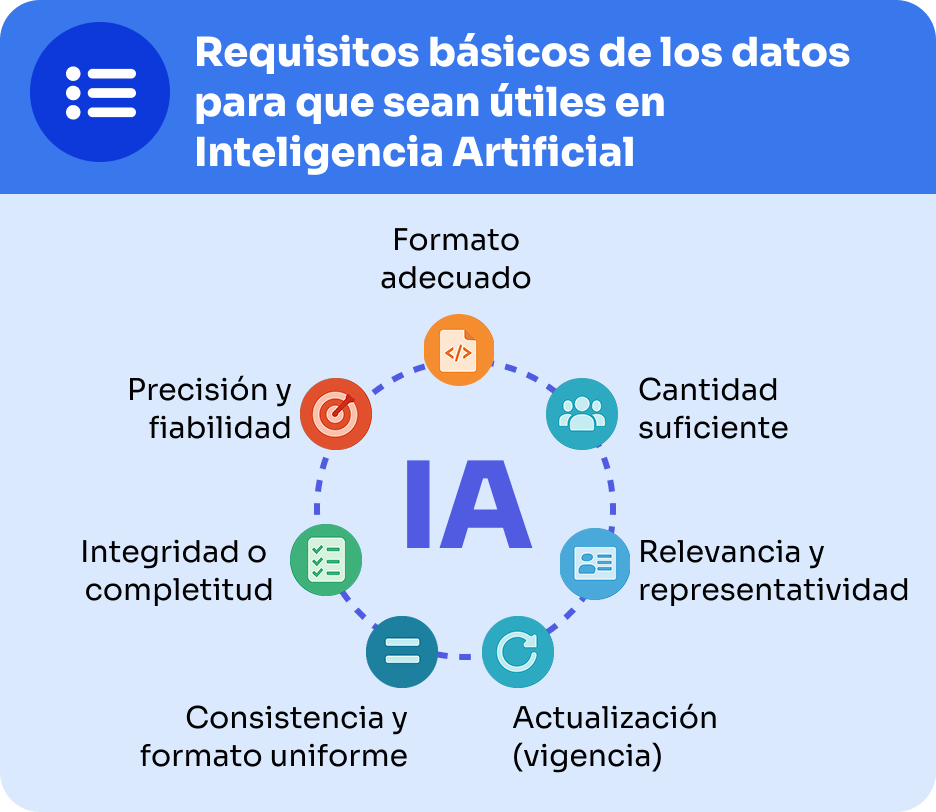

Precisión y fiabilidad

Integridad o completitud

Consistencia y formato uniforme

Actualización (vigencia)

Relevancia y representatividad:

Cantidad suficiente

Formato adecuado para la IA
Metodología paso a paso para preparar datos para la IA
A continuación, se propone una metodología sencilla, paso a paso, que una pyme puede seguir para preparar sus datos antes de implementar herramientas de inteligencia artificial.
Esta guía cubre desde la planificación inicial hasta tener los datos listos para su análisis por sistemas de IA.
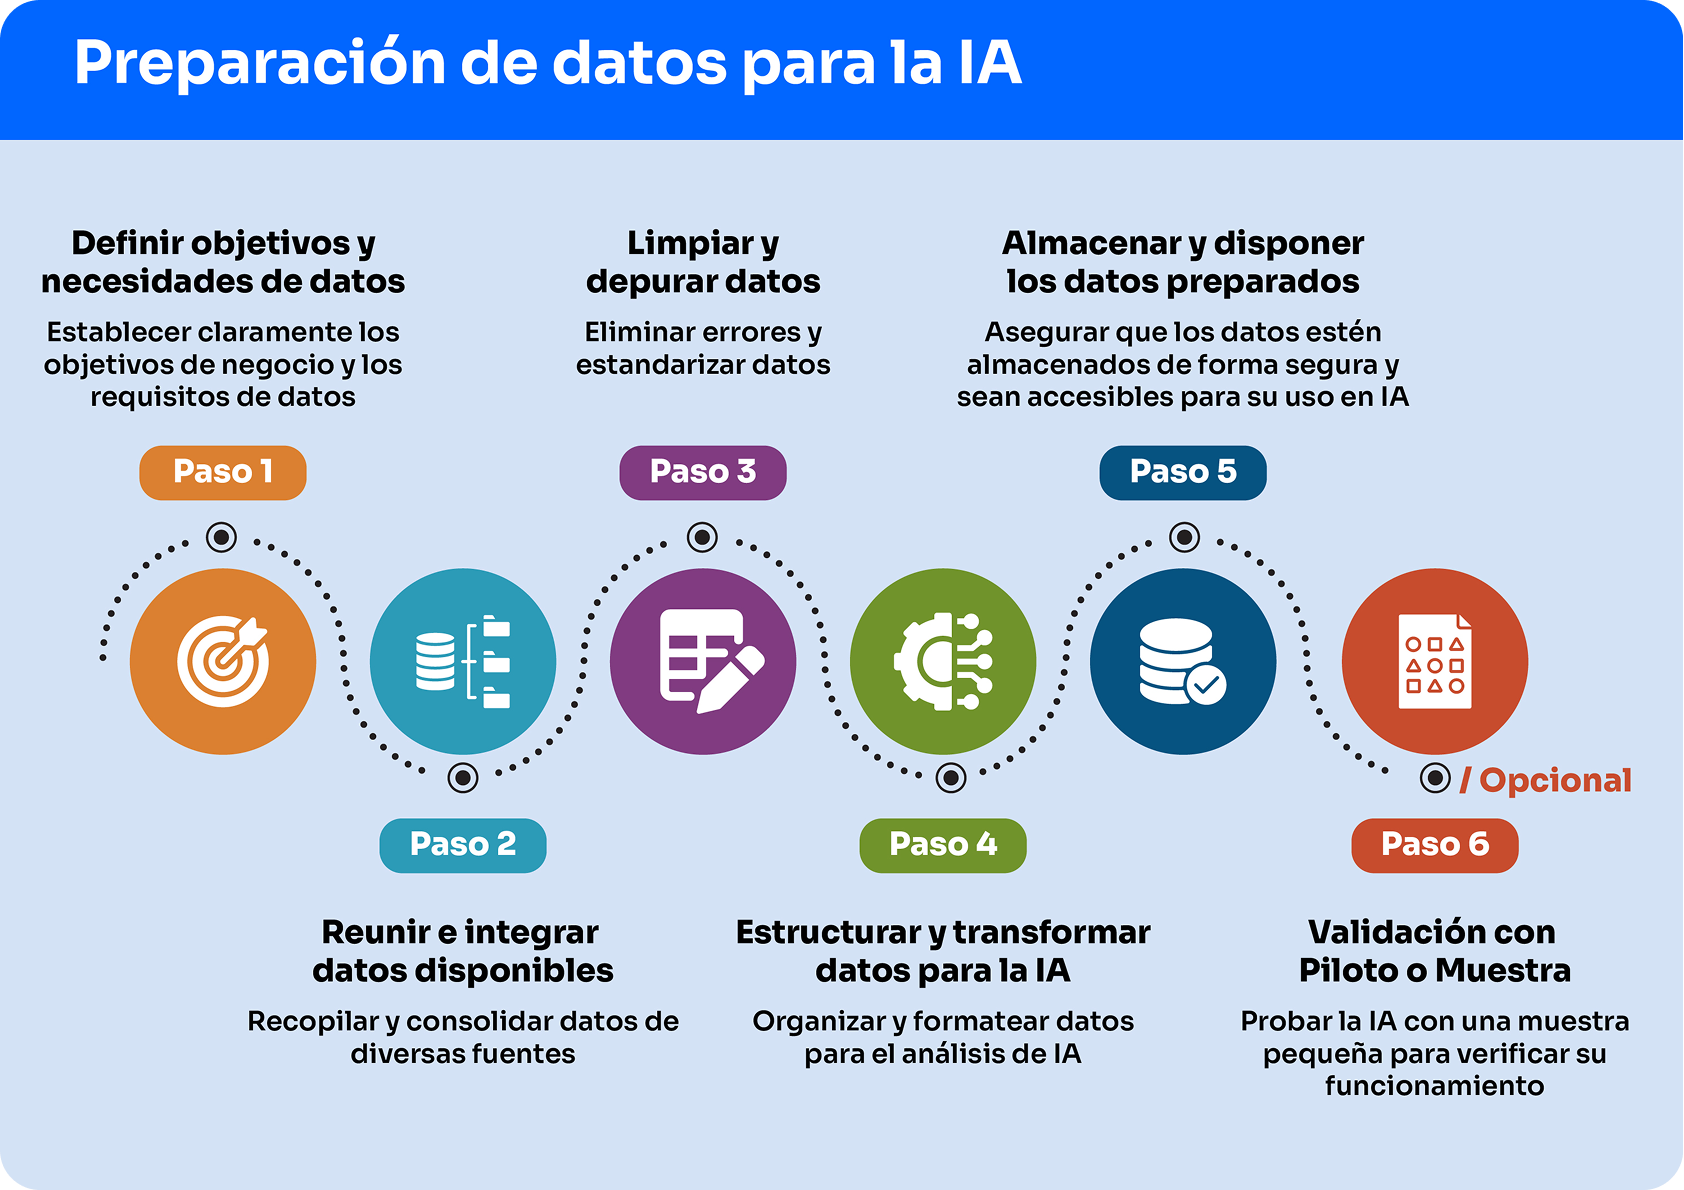
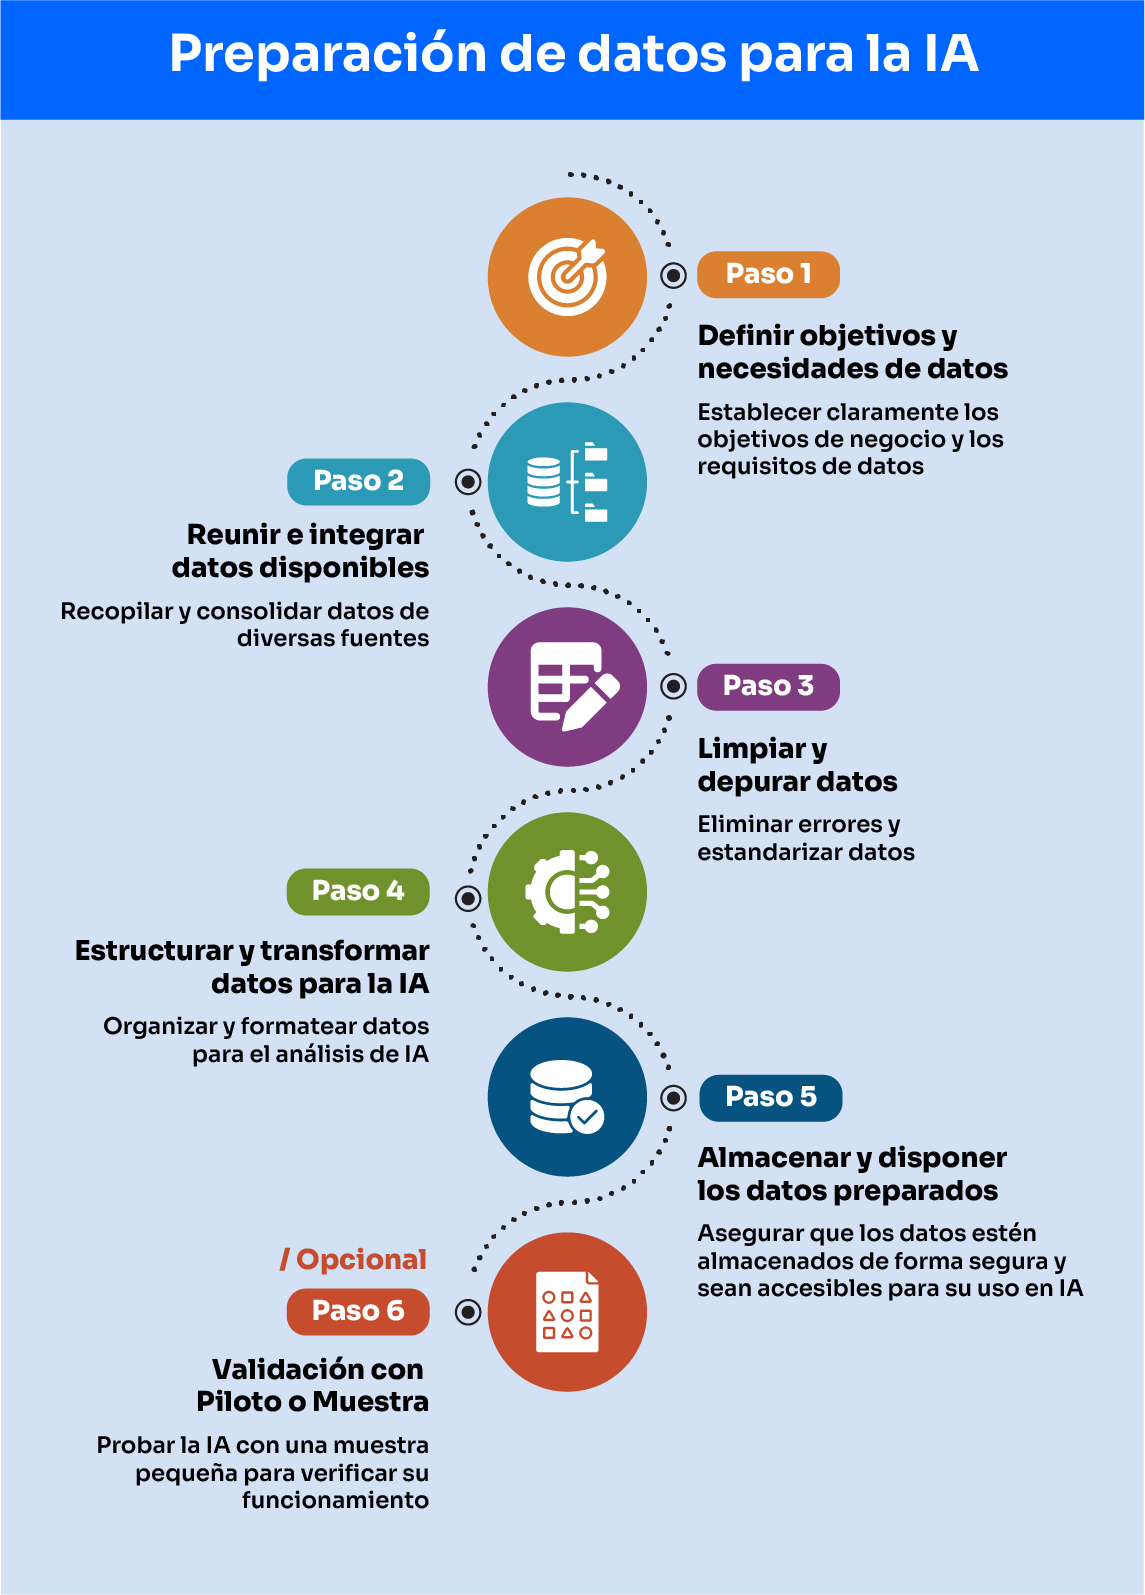
Antes de nada, clarifica qué problema de negocio quieres resolver con IA y qué datos se requieren para ello. Por ejemplo, ¿quieres predecir ventas? entonces necesitarás históricos de ventas y quizá datos de mercado. ¿Optimizar procesos? tal vez datos de tiempos de operación. Define claramente la pregunta a responder o la tarea a automatizar, y haz una lista de los datos indispensables para ese fin. Este paso equivaldría a una auditoría inicial: ¿Qué datos tenemos? ¿Cuáles faltan? . Involucra a los responsables de cada área para identificar qué fuentes de información internas existen (hojas de cálculo de ventas, software de contabilidad, etc.) y verificar si esos datos están accesibles y en qué estado.
Recopila todos los datos relevantes que identificaste. Es posible que estén dispersos en distintos archivos o sistemas; céntralos para poder trabajar con ellos. Por ejemplo, extrae los reportes de ventas de tu sistema de facturación, exporta la lista de clientes del CRM y descarga el inventario desde tu sistema de almacén. Intenta unificarlos en un mismo entorno (una carpeta de trabajo, una base de datos temporal o una hoja de cálculo maestra). En este punto, no filtres aún demasiado, reúne todo lo potencialmente útil. Asegúrate de que cuentas con los permisos necesarios (por ejemplo, datos de clientes deben manejarse con autorización). Como señala una guía, “La IA necesita datos para aprender y operar. Comienza por reunir todos los datos disponibles y prepararlos para el análisis”. Es decir, junta la materia prima antes de empezar a refinarla.
Con todos los datos en la mesa, procede a limpiarlos rigurosamente. Revisa cada conjunto de datos en busca de errores: elimina registros duplicados (por ejemplo, clientes repetidos), corrige campos mal llenados (fechas con formato incorrecto, valores fuera de rango lógico), y completa si es posible los huecos importantes (rellenando manualmente o descartando registros que no sirven por falta de datos clave). Estandariza nombres, categorías y formatos como vimos en las buenas prácticas. Esta fase puede llevar tiempo, pero es crucial. Herramientas simples como Excel permiten, por ejemplo, quitar duplicados automáticamente o usar filtros para encontrar anomalías. También existen herramientas específicas de data cleaning. Lo importante es garantizar que al final de este paso tus datos estén consistentes, sin duplicados y lo más libres de errores posible. Si encuentras datos dudosos cuya calidad no puedas asegurar, es mejor apartarlos del dataset de entrenamiento de IA.
Una vez limpios, da formato a los datos de la manera óptima para analizarlos. Esto puede implicar varias tareas:
- Organizar en tablas o datasets lógicos: Por ejemplo, quizás combines los datos de ventas de distintas tiendas en una sola tabla consolidada con una columna que indique la tienda, para entrenar un modelo único. O dividir datos en conjuntos por tipo (una tabla de clientes, otra de ventas, vinculadas por un ID de cliente).
- Crear nuevas variables o características relevantes: A veces conviene derivar datos adicionales a partir de los existentes. Por ejemplo, a partir de la fecha de una venta puedes crear un campo “mes” o “trimestre” para analizar estacionalidad; desde una lista de transacciones de un cliente podrías calcular su valor de vida (LTV). Estas nuevas características pueden ayudar a la IA a captar patrones.
- Codificar datos categóricos: Si tienes categorías en texto (p. ej. “Sector: Salud, Finanzas, Educación…” para clientes), podrías transformarlas a un formato numérico o de one-hot encoding que los algoritmos manejen mejor. En una fase inicial, incluso un simple código numérico para cada categoría puede servir.
- Normalizar o escalar valores: Si los rangos de datos varían mucho (por ejemplo, ingresos anuales en miles frente a índice de satisfacción de 1 a 5), podría ser útil escalar los valores numéricos a escalas comparables (entre 0-1, o z-score). Esto evita que unas variables dominen sobre otras solo por su magnitud.
- Integrar fuentes diversas: Si obtuviste datos de diferentes sistemas, asegúrate de integrarlos correctamente. Por ejemplo, que el “ID de cliente” coincida entre la tabla de clientes y la de ventas para poder relacionarlos. Esta fase puede implicar hacer merge o uniones entre datasets.
Al final de este paso, deberías contar con uno o varios datasets bien estructurados, listos para alimentar a un modelo o herramienta de IA. Idealmente, documenta brevemente cómo estructuraste los datos y cualquier transformación realizada, para futuras referencias.
Guarda el resultado de la preparación en un lugar seguro y accesible para su uso por la aplicación de IA. Puede ser importar las tablas limpias a un software de análisis, subir un CSV a una plataforma de IA, o cargar los datos en la herramienta específica que vayas a usar (por ejemplo, un módulo de IA de tu software empresarial). Verifica que los datos se cargan correctamente en la herramienta elegida. Asegúrate de conservar una copia maestra de los datos preparados, por si necesitas reutilizarlos o corregir algo. Si el volumen es grande o es información sensible, comprueba que el entorno donde los almacenas es apropiado (respeta la privacidad, tiene suficiente capacidad, etc.). Este es el paso final donde declaras: “mis datos están listos para la IA”. En adelante, cualquier modelo que entrenes o funcionalidad de IA que implementes se basará en este conjunto de datos depurado.
Antes de desplegar un gran proyecto de IA con todos los datos, puede ser útil hacer una pequeña prueba piloto. Por ejemplo, tomar una porción del dataset preparado y usarla para probar la herramienta de IA en cuestión, comprobando si genera resultados lógicos. Esto puede revelar si aún hay problemas en los datos (si la IA arroja resultados extraños, quizás detecte outliers o inconsistencias no vistas). Este paso es opcional pero recomendable en proyectos importantes: piensa en ello como un “control de calidad” final de tus datos ya en acción. Si todo luce bien, entonces procedes con confianza a implementar la solución de IA usando todo el conjunto de datos.
Siguiendo esta metodología, incluso personas sin un perfil técnico avanzado pueden guiarse para dejar los datos listos. La clave es la disciplina en cada paso: no saltar directamente a trabajar con IA sin antes haber pasado por estas etapas. Un proyecto de IA exitoso comienza mucho antes de programar algoritmos, comienza organizando el cajón de datos.
Consideraciones legales y éticas básicas
Al trabajar con datos para inteligencia artificial, especialmente en entornos empresariales, no solo importan los aspectos técnicos, sino también cumplir las leyes y actuar de forma ética.
Las pymes deben tener en cuenta:
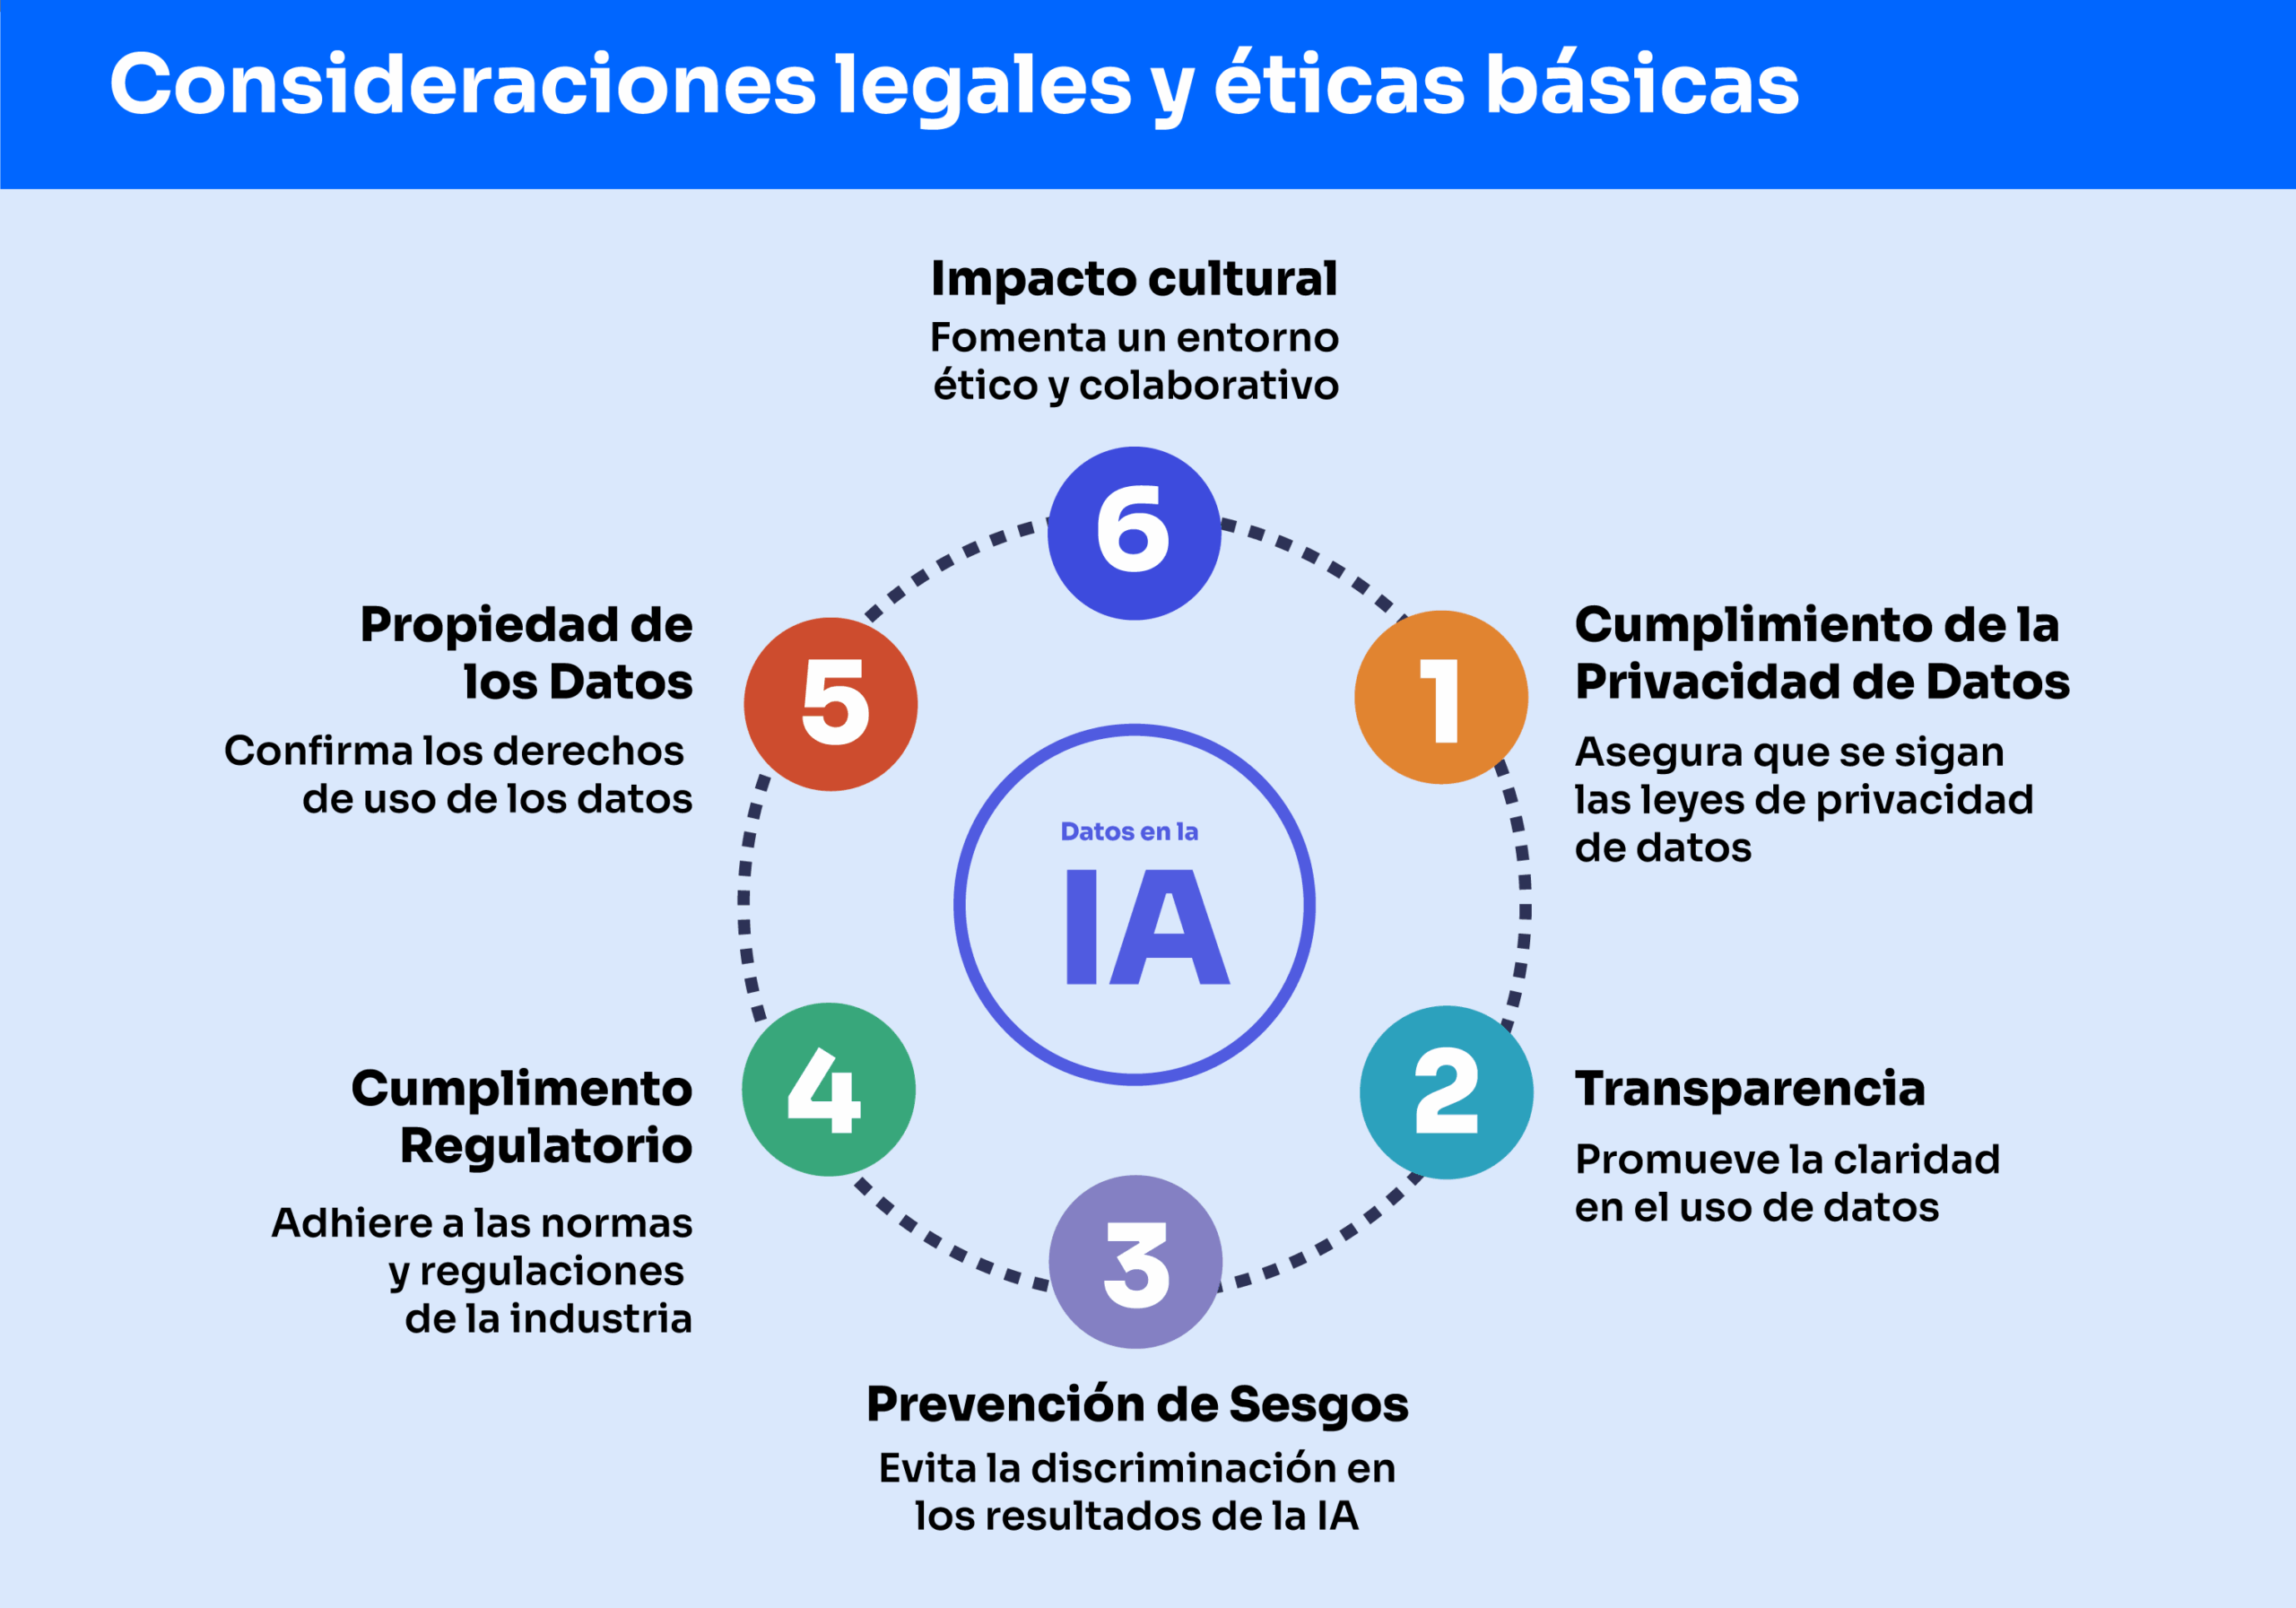
Si los datos incluyen información de personas (clientes, empleados u otros), se debe respetar la legislación vigente en materia de protección de datos. En la Unión Europea aplica el RGPD (Reglamento General de Protección de Datos), y en España además la LOPD GDD ( Ley de Protección de Datos y Garantía de los Derechos Digitales). Estas normas establecen principios como la licitud, transparencia, minimización de datos, exactitud, integridad y confidencialidad en el tratamiento de datos personales . En práctica, esto implica:
Si la IA va a tomar decisiones que afecten a individuos (por ejemplo, un modelo que priorice leads de clientes para ofertas, o un sistema que filtre CVs de candidatos), se debe procurar cierta transparencia. Las personas tienen derecho a saber que se usan sus datos y para qué. En algunos casos, podrían incluso solicitar no ser sujetos de decisiones automatizadas adversas sin intervención humana (esto es parte del RGPD). Para una pyme, esto significa ser clara en sus políticas de privacidad sobre el uso de IA y, en casos sensibles, mantener la supervisión humana en las decisiones importantes.
Un aspecto ético clave es el de los sesgos en los datos. Si los datos históricos reflejan prejuicios o desigualdades (por ejemplo, menos contrataciones de cierto grupo, o un sesgo hacia clientes de cierta zona), la IA puede aprender esos sesgos y perpetuarlos o incluso amplificarlos . Esto podría conducir a discriminación inadvertida. Para prevenirlo:
- Revisa tus datos buscando posibles sesgos. Por ejemplo, segmenta por género, edad, región, y analiza si hay distribuciones muy desequilibradas.
- Si identificas un sesgo (p.ej., 90% de tus datos de clientes son de una ciudad pudiente), sé consciente de que un modelo podría no generalizar bien fuera de ese perfil. Quizás necesites complementar con datos más diversos si es posible.
- No incluyas variables sensibles (raza, religión, orientación sexual, etc.) en modelos de IA a menos que sea absolutamente necesario y estés seguro de poder gestionar el impacto ético. Incluso datos aparentemente neutrales pueden actuar como proxies de datos sensibles; hay que ser cauteloso.
- Tras entrenar un modelo de IA, prueba sus resultados en distintos subgrupos para detectar comportamientos injustos. Si una IA de selección de CV favoreciera injustamente a hombres sobre mujeres, por ejemplo, habría que recalibrar los datos o el modelo. Las pymes pueden también implementar auditorías internas sencillas de sus algoritmos para evaluar equidad .
Además del RGPD, se avecinan (o ya existen) regulaciones específicas de IA. La Ley de IA de la UE (AI Act) establecerá requisitos adicionales, especialmente si la IA se usa en ámbitos de alto riesgo (finanzas, salud, recursos humanos, etc.). Aunque una pyme promedio tal vez no entre en escenarios de “alto riesgo”, es bueno estar informados. En términos de datos, estas normativas apuntan a la necesidad de documentar muy bien el origen y tratamiento de los datos usados en IA, para garantizar trazabilidad y responsabilidad . En la práctica, mantener registros de cómo se obtuvieron y procesaron los datos para entrenar un modelo podría volverse obligatorio en ciertos casos.
Asegúrate de que la empresa tiene derecho a usar los datos en la forma prevista. Si los datos son propios (generados por la empresa), no hay problema. Pero si provienen de terceros, hay que verificar licencias o acuerdos (por ejemplo, usar una base de datos comprada, datos de redes sociales, etc., pueden tener restricciones). Además, si se utilizan datos públicos o abiertos, conviene atribuir la fuente según corresponda.
Cuando se implementa IA en una pyme, comunicar claramente su propósito puede aliviar temores (por ejemplo, miedo a que la IA reemplace empleos). En términos éticos, hay que usar la IA como apoyo, no necesariamente como sustituto absoluto, y ofrecer capacitación al personal para colaborar con estas nuevas herramientas. Involucrar a los empleados en la iniciativa (explicarles qué hará la IA con los datos y cómo beneficiará su trabajo) crea un entorno más positivo y reduce resistencia.
Ejemplos prácticos
Para aterrizar estos conceptos, veamos ejemplos prácticos de cómo una pyme podría preparar sus datos en situaciones reales de uso de IA. Tomaremos dos casos: uno enfocado en datos de ventas para hacer una predicción de demanda, y otro en datos de clientes para automatización de marketing. En cada caso, describiremos qué pasos seguir para dejar los datos listos y útiles.
Ejemplo 1
Preparación de datos de ventas para predicción de demanda

Contexto
Supongamos una pyme del sector retail que quiere utilizar IA para predecir la demanda futura de sus productos. El objetivo es anticipar cuántas unidades venderá en los próximos meses, para optimizar su inventario. Para ello, la empresa necesita preparar su histórico de ventas como entrada de un modelo de pronóstico (por ejemplo, un modelo de series temporales o alguna herramienta de predicción).

Datos necesarios
Principalmente, se requerirán los registros de ventas históricas. Esto incluye la fecha de cada venta, el producto vendido (o categoría), y la cantidad vendida (o el importe). Idealmente se tendrá al menos 1-2 años de datos de ventas diarias o mensuales para captar estacionalidad. También pueden ser útiles datos adicionales como: fechas de promociones o descuentos (que influyen en las ventas), días festivos, o cualquier factor externo que pueda afectar la demanda.

Pasos para la preparación
Reunir los datos de ventas: La pyme exporta desde su sistema de punto de venta o facturación todas las transacciones de, digamos, los últimos 24
meses. Obtiene un listado en Excel o CSV con columnas como: Fecha, ID Producto, Cantidad Vendida, Precio, etc. Si las ventas están desglosadas por día, pero el modelo será mensual, se puede luego agrupar por mes.
Limpiar y estructurar: Se verifica que no haya ventas duplicadas registradas (no debería, pero por ejemplo evitar contar dos veces una factura). También se chequea la consistencia: que las fechas estén en orden, sin datos faltantes en el calendario (si algún día/mes faltante, decidir si fue cero ventas o dato perdido). Se uniformizan los identificadores de producto o categorías. Si hay outliers extraños (p.ej., un pico de ventas inusualmente alto que se deba a un error de registro), se anotan para tratarlos.
Formatear para análisis temporal: Para facilitar el análisis, se reestructura la información en una serie temporal. Por ejemplo, crear una tabla con columnas «Mes» y «Ventas_totales» que sume todas las ventas de ese mes, si se va a predecir a nivel global. O bien una serie por producto si se desea pronosticar cada uno. Ejemplo: una hoja de cálculo con 2 columnas: Mes (enero 2023, feb 2023, …) y Ventas (unidades vendidas ese mes) . De esta forma, el modelo podrá ver la secuencia cronológica claramente.
Añadir variables relevantes: Si se dispone de información de promociones, se puede añadir una columna binaria indicando meses con promoción, para que el modelo aprenda esos efectos. O marcar festivos importantes. También podría calcularse la variación % mes a mes y añadirla como referencia. Cualquier dato externo (como clima, si afectara, o índices económicos) podría incorporarse en columnas paralelas, siempre alineadas por fecha.
Dividir datos para validación: En predicción de demanda es común reservar los últimos meses como conjunto de test para validar luego la precisión de la predicción. Así que la pyme podría separar, por ejemplo, los datos hasta el mes 18 para entrenar y dejar meses 19-24 para comprobar cómo predice el modelo. Esta separación es parte de la preparación conceptual.
Herramienta a usar: Con los datos listos, la empresa puede usar una herramienta accesible. Incluso Excel ofrece métodos sencillos de pronóstico: por ejemplo, la función de suavizamiento exponencial en análisis de datos puede proyectar la tendencia . En este caso, se cargarían los datos mensuales preparados en Excel y se aplicaría dicha función para obtener la predicción del mes siguiente. Para enfoques más avanzados, se pueden usar herramientas de business intelligence o bibliotecas de Python / R, pero el punto es que la base de datos esté lista.
Resultado esperado: Tras entrenar un modelo o aplicar el método de pronóstico sobre los datos preparados, la pyme obtendría una estimación de ventas futuras (por ejemplo, ventas esperadas para cada uno de los próximos 6 meses). Lo importante es que, gracias a la preparación de los datos, la predicción se basa en un historial sólido y confiable. La empresa podría entonces ajustar su inventario y compras de insumos de acuerdo con esas previsiones, reduciendo quiebres de stock o excesos.
Ejemplo 2
Preparación datos clientes para automatización del marketing
Contexto
Imaginemos ahora una pyme de servicios que quiere implementar una herramienta de marketing automatizado con IA. Por ejemplo, desea usar IA para segmentar automáticamente a sus clientes y enviar campañas personalizadas (emails, ofertas) según el perfil de cada uno. Para lograrlo, necesita consolidar y preparar sus datos de clientes de forma que la herramienta de marketing/IA pueda analizarlos y encontrar segmentos o patrones de comportamiento.
Datos necesarios
Aquí serán importantes todos los datos que describen a los clientes y sus interacciones con la empresa. Por ejemplo:
Datos demográficos o de perfil: edad, género, ubicación, tamaño de la empresa (si son clientes B2B), sector, etc.
Historial de compras o de uso de servicios: qué productos/servicios ha adquirido cada cliente, cuánto gasta, frecuencia de compra, última fecha de compra.
Interacción con marketing: apertura de emails, clics en enlaces, visitas al sitio web, seguimiento en redes sociales, respuestas a encuestas, etc.
Estado del cliente: si está activo, inactivo, si es un lead (potencial) o cliente ya ganado, etc.
Estos datos pueden provenir de varias fuentes: un CRM, una plataforma de email marketing, hojas de cálculo de ventas, etc. La tarea principal es unificar el perfil del cliente.
Pasos para la preparación
Consolidar la base de datos de clientes: El primer paso es tener una lista única de clientes. La pyme debe unificar los registros que pueda tener duplicados. Por ejemplo, es común que en marketing se tenga una lista de suscriptores de newsletter y en ventas otra de clientes; hay que fusionarlas identificando quiénes son la misma persona/empresa. Se crea así una tabla maestra donde cada fila corresponde a un cliente único, con un identificador claro.
Integrar las diferentes fuentes de datos: Una vez listados los clientes únicos, se añaden columnas o campos con la información de cada fuente: ○ Del sistema de ventas: total comprado por el cliente, fecha de última compra, productos comprados, etc.
- De la plataforma de marketing: tasa de apertura de emails, si asiste a webinars, origen del lead (ej. web o referidos), etc.
- Del servicio al cliente: si ha hecho reclamos, satisfacción, etc.
Esto puede requerir hacer coincidir los datos por email, por ID de cliente u otro campo común. Es un proceso de integración. Herramientas de CRM modernas hacen mucho de esto automáticamente, pero si no, puede hacerse exportando todo a Excel y combinando mediante búsquedas o tablas dinámicas.
Limpieza y actualización: Con la información integrada, limpiamos lo necesario: eliminar clientes fallecidos o que pidieron baja (no deben ser contactados, y según indica el RGPD deben ser removidos), corregir emails mal escritos, completar campos críticos vacíos si es posible (por ejemplo, agregar el sector de un cliente si falta, consultando a los vendedores). También asegurarse de actualizar el estado: marcar quiénes ya no interactúan hace mucho (p. ej., clientes inactivos 1 año).
Estandarización: Estandarizar formatos, por ejemplo, todos los números de teléfono con código de país, todos los nombres de provincias escritos igual (para poder segmentar por región sin duplicados). También unificar categorías: si en una fuente ponía «VIP» para clientes premium y en otra «Premium», elegir una sola nomenclatura.
Enriquecimiento (opcional): A veces se puede enriquecer los datos añadiendo información externa. Por ejemplo, quizás obtener el sector y tamaño de empresa de cada cliente B2B de una base pública, para luego segmentar mejor. O usar la ubicación para asignar cada cliente a una región geográfica. Esto no siempre es posible, pero si la herramienta de IA va a segmentar, cuantos más datos relevantes tenga de cada cliente, mejor podrá agruparlos.
Segmentación inicial o etiquetas: Antes de aplicar IA, la empresa podría ya definir algunas etiquetas o segmentos básicos para guiar el proceso. Por ejemplo, marcar clientes «frecuentes» vs «ocasionales» según frecuencia de compra, o «Sector Salud / Finanzas / …». Estas etiquetas pueden servir luego para validar si la IA encuentra grupos similares.
Uso de la herramienta de IA de marketing: Con la base de datos de clientes unificada y limpia, se carga en la herramienta de marketing automation o análisis con IA. Muchas de estas plataformas (Mailchimp, HubSpot, etc.) permiten importar un CSV con los contactos y sus atributos. Una vez dentro, se puede usar la funcionalidad de segmentación inteligente. Por ejemplo, Mailchimp tiene recomendaciones de segmentos basados en comportamiento, o algunas CRMs ofrecen clustering de clientes por valor. La IA analizará patrones en campos como monto gastado, categorías de interés, etc., y agrupará clientes similares.
Ejemplo de resultado: La IA podría descubrir, por decir, un segmento de clientes jóvenes urbanos que compran mensualmente productos económicos, otro segmento de clientes corporativos que contratan servicios premium anualmente, etc. Con esos segmentos identificados, la pyme puede automatizar campañas específicas (por ejemplo, enviar un email con productos populares del mes a los primeros, o una oferta de renovación a los segundos). Importante: todo esto fue posible porque se preparó adecuadamente la data de clientes: sin una vista 360° del cliente, la IA no tendría suficiente información para diferenciar perfiles.
Herramientas accesibles para la gestión de datos en pymes
La buena noticia para las pymes es que no se requiere un gran presupuesto ni infraestructuras complejas para empezar a gestionar y preparar datos adecuadamente. Existen múltiples herramientas accesibles (muchas de ellas no-code) que pueden ayudar en cada etapa del proceso, aprovechables por usuarios con conocimientos básicos de ofimática
Son aliadas clásicas y potentes. Permiten almacenar datos en forma tabular, realizar limpiezas simples (buscar y reemplazar, eliminar duplicados, aplicar filtros), crear tablas dinámicas para integraciones básicas, y generar gráficos o análisis preliminares. Excel, por ejemplo, incluye funciones avanzadas como el Análisis de Datos que puede usarse para pronósticos sencillos. Google Sheets tiene la ventaja de ser colaborativo en la nube, ideal para que varias personas trabajen sobre la misma base de datos en tiempo real.
A medida que crece la cantidad de datos, una base de datos puede brindar más robustez que una hoja de cálculo. Herramientas como Microsoft Access (local) o servicios online tipo Airtable o Google Cloud Firestore ofrecen almacenamiento estructurado con interfaz amigable. Si la pyme ya utiliza un CRM (como HubSpot, Zoho CRM, Salesforce), debe aprovecharlo al máximo: estos sistemas centralizan datos de clientes y suelen tener opciones para mantener la calidad (evitar duplicados, campos obligatorios, etc.). Además, muchos CRMs incorporan módulos de IA o analítica que luego pueden emplearse directamente con los datos ahí contenidos.
Para automatizar la recolección y actualización de datos desde distintas fuentes, existen plataformas no-code de integración como Zapier, Make o Microsoft Power Automate. Estas herramientas permiten, por ejemplo, que cada nueva venta registrada en el sistema de facturación automáticamente actualice un Google Sheet resumido, o que se sincronice contactos entre una hoja de cálculo y el CRM. Sin necesidad de programar, una pyme puede montar flujos que mantengan sus datos más integrados y actualizados en tiempo real.
En el mercado hay soluciones específicas para limpiar y depurar datos de forma amigable. Por ejemplo, WinPure y otras plataformas de Data Quality orientadas a pymes ofrecen interfaces para cargar datos y ayudan a identificar duplicados, valores inconsistentes, errores tipográficos, etc., sin escribir código. Estas herramientas están diseñadas para ser usadas por personal no técnico, reduciendo esfuerzo en garantizar la limpieza de grandes listas de datos (como una base de 10.000 clientes).
Si bien se enfocan en análisis, también ayudan en la preparación de datos. Herramientas como Power BI, Tableau (tienen versiones gratuitas o de bajo costo) o Google Data Studio (Looker Studio) permiten conectar diversas fuentes de datos, hacer transformaciones básicas (combinar tablas, crear campos calculados) y luego visualizar resultados. Pueden ser útiles para detectar problemas en datos a través de visualizaciones. Por ejemplo, un gráfico de ventas mensuales en Data Studio podría revelar un mes “hueco”, indicando un posible dato faltante.
Si en la pyme hay alguien con nociones de programación, lenguajes como Python ofrecen librerías (pandas, etc.) para manipular datos muy eficientemente. Sin embargo, para los objetivos de este manual, destacamos que casi todo se puede lograr con herramientas no-code. Aun así, saber que existe la posibilidad de pequeños scripts para tareas repetitivas es bueno: por ejemplo, un script Python podría normalizar 1,000 nombres de forma consistente. Pero insistimos: no es indispensable, sólo complementar en casos particulares.
Por último, cuando ya tengas los datos listos, hay herramientas de IA user-friendly que permiten entrenar modelos sin programar. Por ejemplo, servicios de AutoML (Automated Machine Learning) de Google Cloud o Azure, o plataformas como BigML o DataRobot enfocadas en usuarios de negocio. Estas suelen aceptar tus datos en CSV y guiarte para entrenar un modelo de predicción o clustering. Algunas incluso te señalan si tus datos tienen problemas (como demasiados nulos o un desequilibrio en clases). Aprovechar estas herramientas puede ser el paso final después de la preparación de datos, para obtener modelos sin tener que construirlos desde cero.
Conclusión
El valor de los datos en inteligencia artificial reside en su capacidad de convertir información en conocimiento, y el conocimiento en decisiones acertadas. La inteligencia artificial no puede funcionar sin una base sólida de datos confiables, bien organizados y éticamente gestionados.
Para una pyme, aprender a gestionar sus datos de forma efectiva no solo significa aprovechar el potencial de la IA, sino también mejorar su toma de decisiones, anticiparse a los cambios del mercado y crear experiencias más personalizadas para sus clientes.
La buena gestión de datos se traduce en procesos más eficientes, ahorro de tiempo, menos errores humanos y más oportunidades de innovación. A medida que las herramientas de IA se vuelven más accesibles, las empresas que hayan hecho este trabajo previo con sus datos estarán en mejor posición para escalar, automatizar y competir con garantías.
Glosario de términos clave
Datos (Data)
En este contexto, se refiere a la información recopilada y almacenada por la empresa. Pueden ser números, texto, imágenes, etc., que representan hechos relevantes (por ejemplo, registros de ventas, lista de clientes, datos financieros). Son la materia prima que utiliza la IA para aprender.
Inteligencia Artificial (IA)
Rama de la informática que desarrolla sistemas capaces de realizar tareas que normalmente requieren inteligencia humana, como aprender de ejemplos, tomar decisiones o predecir eventos. En PYMEs suele aplicarse en herramientas que analizan datos y automatizan decisiones (ej.: un algoritmo que predice qué clientes podrían comprar cierto producto).
Dataset (Conjunto de datos)
Colección de datos organizada de forma estructurada, típicamente en forma de tabla o varias tablas relacionadas. Es el conjunto que se utiliza para entrenar un modelo de IA o para realizar un análisis específico. Ej: un dataset de clientes con columnas de atributos (edad, sector, compras, etc.).
Datos estructurados
Datos organizados en un formato fijo, como tablas con filas y columnas, donde cada columna es una variable bien definida. Son fáciles de buscar y analizar. Ejemplos: una hoja de cálculo de ventas, una tabla de base de datos relacional.
Datos no estructurados
Información que no sigue un esquema predefinido de organización. Puede ser texto libre, imágenes, audio, correos electrónicos, documentos PDF, etc. Requieren procesamiento adicional para extraer información útil. Ejemplo: el contenido de emails de clientes es no estructurado, habría que procesarlo (p.ej. con NLP) para obtener categorías de consulta.
Calidad de datos
Medida en que los datos son aptos para su propósito. Implica que sean precisos (sin errores), completos (sin datos faltantes importantes), consistentes (coherentes entre sí y a lo largo del tiempo), actualizados y relevantes. La alta calidad de datos es fundamental para obtener buenos resultados de IA.
Limpieza de datos (Data cleaning o depuración)
Proceso de detectar y corregir (o eliminar) errores y problemas en los datos. Incluye eliminar duplicados, corregir errores tipográficos, rellenar o eliminar valores faltantes, asegurar consistencia de formatos, etc. Es una etapa del preprocesamiento de datos antes de análisis o modelado.
Preprocesamiento de datos:
Etapa previa al modelado de IA donde se preparan los datos. Abarca la limpieza, transformación de variables (escalares, codificación de categorías), selección de características relevantes, etc. Todo lo que se hace a los datos brutos para dejarlos listos para alimentar un algoritmo de IA.
Sesgo (bias) en datos/IA:
Distorsión presente en los datos que puede causar que un modelo de IA genere resultados parciales o discriminatorios. Por ejemplo, si en los datos de entrenamiento la mayoría de clientes exitosos pertenecen a un grupo X, el modelo podría favorecer indebidamente a ese grupo. El sesgo puede provenir de datos históricos que reflejan inequidades o muestras no representativas.
Gobernanza de datos:
Conjunto de políticas, procedimientos y roles que aseguran la gestión eficaz de los datos en la organización. Incluye aspectos de calidad, seguridad, privacidad y alineación con objetivos de negocio. En PYMEs, la gobernanza define quién es responsable de los datos, cómo se controlan los accesos, cómo se mantiene la calidad, etc., garantizando que los datos se traten como un activo estratégico.
RGPD (GDPR):
Reglamento General de Protección de Datos de la Unión Europea. Ley que regula cómo se deben manejar los datos personales (de individuos) para proteger su privacidad. Impone principios de tratamiento de datos (transparencia, minimización, exactitud, seguridad, etc.) y otorga derechos a las personas sobre sus datos (acceso, rectificación, borrado, oposición a decisiones automatizadas, etc.). Las PYMEs que tratan datos personales de europeos deben cumplirlo.
Anonimización:
Proceso de modificar datos personales de manera que ya no sea posible identificar a la persona a la que se refieren. Por ejemplo, quitar nombres y cualquier dato identificativo, o agregarlos estadísticamente. Un dato anonimizado correctamente deja de considerarse dato personal (según RGPD). Alternativamente, la seudonimización reemplaza identidades reales por identificadores ficticios (como códigos), reduciendo riesgos pero permitiendo re-identificar con una “llave” separada
Automatización (de marketing, procesos, etc.):
Uso de sistemas (muchas veces con IA) para ejecutar tareas de forma automática sin intervención humana continua. En marketing, por ejemplo, automatización es programar envíos de emails personalizados según acciones del cliente, o segmentar listas automáticamente. La IA potencia la automatización al tomar decisiones más sofisticadas (p.ej., determinar el mejor horario para enviar un mensaje a cada cliente)
No-code / Low-code:
Herramientas tecnológicas que permiten desarrollar aplicaciones o procesos sin necesidad de escribir código de programación (o con muy poco código). Para gestión de datos, herramientas no-code son aquellas que mediante interfaces gráficas permiten integrar, limpiar o analizar datos (por ejemplo, construir un flujo de ETL en un entorno visual). Están pensadas para que usuarios de negocio puedan realizar tareas complejas sin ser programadores.